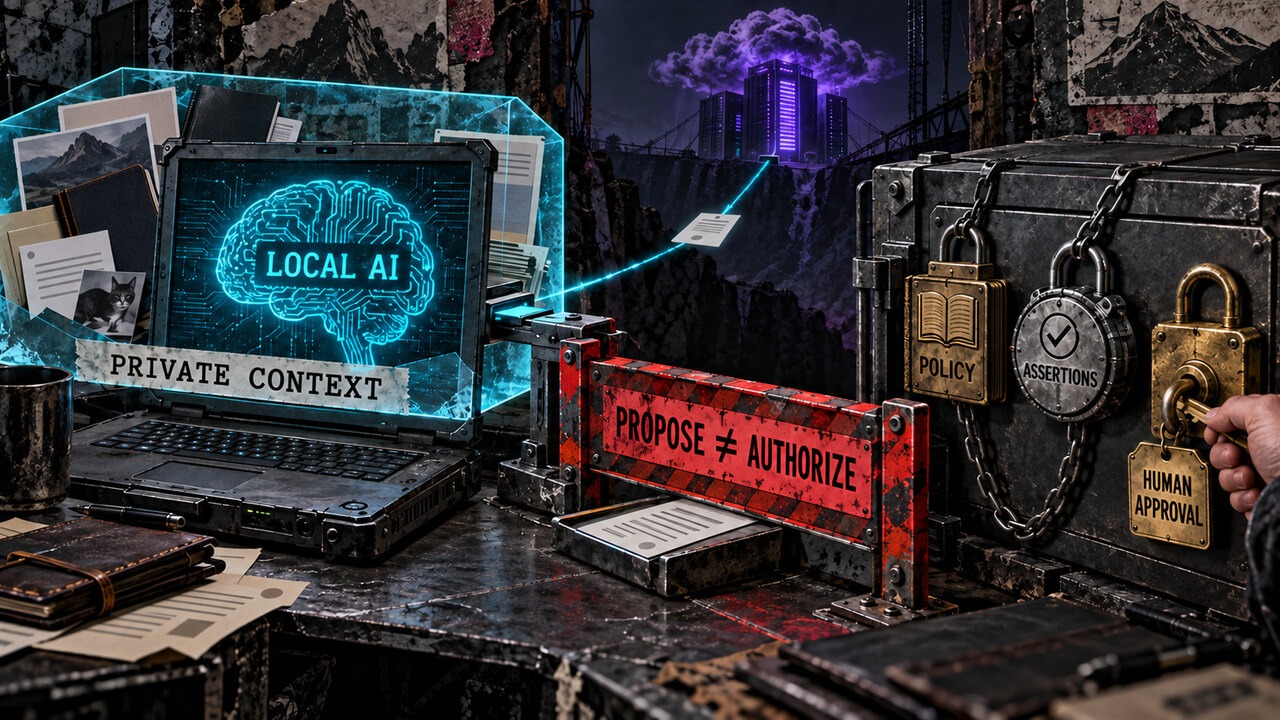
La inteligencia artificial ejecutada en el propio ordenador está cerca de convertirse en una herramienta práctica para una parte amplia de las tareas cotidianas, según Vitalik Buterin. El cofundador de Ethereum sostiene que los avances recientes permiten mantener más información privada y responder con rapidez, aunque advierte de que los monederos de criptomonedas todavía necesitan controles adicionales antes de confiar a un modelo el acceso a los activos.
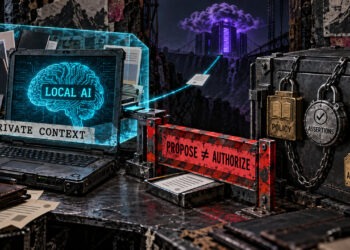
Buterin explicó el 17 de septiembre que Qwen 3.8 Flash y las mejoras incorporadas a llama.cpp habían acercado los modelos locales a un punto de inflexión en su portátil Strix Halo. En su valoración, estos sistemas ya pueden encargarse de una “gran parte” de las tareas. Cuando se necesita más capacidad, el modelo local puede coordinar consultas con servicios remotos y enviar únicamente la pregunta o el contexto que considere necesario, en lugar de exponer todos los archivos, mensajes y datos personales del usuario.
Un salto práctico para la IA local
La imagen de referencia publicada junto al comentario recogía diez cargas de trabajo. Las velocidades de procesamiento de entrada se situaban entre 109,82 y 373,22 tokens por segundo, mientras que la generación de salida oscilaba entre 18,42 y 33,37 tokens por segundo. Son cifras obtenidas en un portátil de gama alta y respaldan la idea de que la interacción puede resultar suficientemente ágil en un escenario real.
La evaluación de septiembre supone un cambio respecto a la descripción que Buterin hizo en abril de su configuración. Entonces señalaba que Qwen3.5:35B podía resolver tareas acotadas y trabajos de programación conocidos, pero que los agentes capaces de trabajar de forma independiente y sostenida sobre una base de código seguían fuera del alcance práctico de los ordenadores personales. El trabajo de mayor complejidad todavía requería modelos remotos más potentes.
La nueva configuración no limita el modelo local a transcribir, resumir o completar encargos muy concretos. Puede actuar como interfaz principal, decidir cuándo hace falta recurrir a un sistema remoto y filtrar la información que sale del dispositivo. Aun así, los datos publicados no incluyen el contenido de las instrucciones, las opciones de cuantización ni la configuración completa de ejecución, por lo que no permiten extrapolar ese rendimiento a cualquier equipo.
Qwen3.8-Flash-Next, desarrollado por el equipo de Qwen de Alibaba, es un modelo multimodal de pesos abiertos basado en una arquitectura de mezcla de expertos. Su modelo principal cuenta con 125.000 millones de parámetros y otros 51.000 millones en tablas de incrustaciones de n-gramas, aunque activa 6.000 millones por token. El repositorio oficial documenta su ejecución local de texto e imagen mediante llama.cpp y versiones GGUF cuantizadas. Activar solo una parte del modelo reduce la carga de cálculo, pero la memoria necesaria depende de la versión elegida y del contexto de uso.
La capacidad del modelo no equivale a autoridad sobre los fondos
El informe técnico de Qwen mide conocimientos generales, matemáticas, ciencia, razonamiento, programación y comprensión multilingüe en 14 pruebas. El equipo asegura que Flash-Next superó al modelo base Qwen3.7-Plus en ocho de ellas utilizando menos parámetros activos y menor capacidad de entrenamiento. Esos resultados describen capacidad, eficiencia y estabilidad, pero no resuelven cuestiones como la resistencia a instrucciones maliciosas, la aplicación de políticas o la autorización de operaciones financieras.
Un asistente local puede explicar una transacción, preparar datos de llamada o proponer una ruta. Sin embargo, la firma puede desencadenar una transferencia irreversible o conceder a un contrato permiso para mover activos. Una instrucción oculta en una web, un mensaje o la descripción de una operación podría alterar el plan del modelo. Por eso, el razonamiento del sistema no debe confundirse con una autorización suficiente.
La Fundación Ethereum ya está probando una idea similar con Steward, un monedero de cuenta inteligente para macOS cuyo cliente ligero y asistente de IA están concebidos para funcionar en el dispositivo. La actualización de asignación correspondiente al segundo trimestre confirma la financiación y el alcance del proyecto, pero no establece que exista un despliegue de producción, una auditoría independiente o capacidad para autorizar transacciones de forma autónoma.
Controles separados para las operaciones de riesgo
Las recomendaciones de Buterin de abril situaban la protección fuera del modelo: confirmación humana para las acciones sensibles, límites deterministas sobre importes, datos de llamada y número de transacciones, y una regla de aprobación conjunta entre persona y modelo, equivalente a un esquema 2 de 2. La automatización de bajo riesgo —consultar saldos, preparar operaciones sin firmar o trabajar con límites estrictos— puede mantenerse sin conceder capacidad de gasto abierta.
El borrador EIP-7906 plantea además marcos de aserción posteriores a la transacción para comprobar las diferencias finales de estado. Así, un monedero podría exigir que un intercambio afectase solo a saldos autorizados o que no aparecieran permisos ocultos sobre tokens. Estas verificaciones deben cubrir todos los cambios relevantes: una regla incompleta puede generar una falsa sensación de seguridad.
La IA local protege mejor el contexto y puede convertirse en una interfaz rápida para proponer acciones. Las políticas deterministas, las comprobaciones del resultado y la aprobación humana cumplen otra función: conservar la autoridad fuera del modelo. El avance descrito por Buterin hace más creíble el primer componente, pero no elimina la necesidad de los demás cuando están en juego activos digitales.