Vitalik Buterin considera que la inteligencia artificial ejecutada directamente en un ordenador personal está cerca de un punto de inflexión práctico. Según el cofundador de Ethereum, los avances de Qwen 3.8 Flash y de llama.cpp permiten que un portátil gestione ya una parte amplia de las tareas habituales con una respuesta suficientemente rápida, aunque esa evolución todavía no basta para confiarle el control directo de una cartera de criptomonedas.
Modelos locales más rápidos y con más margen de actuación
Buterin expuso su valoración el 17 de septiembre después de probar estos sistemas en un portátil equipado con Strix Halo. La imagen de referencia que acompañaba a su publicación recogía diez cargas de trabajo. Las tasas de procesamiento de entrada se situaban entre 109,82 y 373,22 tokens por segundo, mientras que la generación de respuestas oscilaba entre 18,42 y 33,37 tokens por segundo.
Las cifras describen el rendimiento de un equipo de alta gama concreto, no una garantía aplicable a cualquier ordenador. Además, no permiten por sí solas evaluar la calidad del razonamiento, la resistencia a instrucciones maliciosas o la seguridad de las decisiones financieras. Sí respaldan, en cambio, la idea de que un modelo local puede ofrecer una interacción suficientemente ágil para tareas cotidianas.
El cambio es relevante frente a la valoración que Buterin hizo en abril. Entonces describía Qwen3.5:35B como una herramienta adecuada para trabajos acotados y programación conocida, pero señalaba que los agentes capaces de trabajar de forma independiente durante más tiempo sobre una base de código seguían fuera del alcance práctico de los portátiles. Las tareas de programación y análisis más exigentes requerían modelos remotos con mayor capacidad.
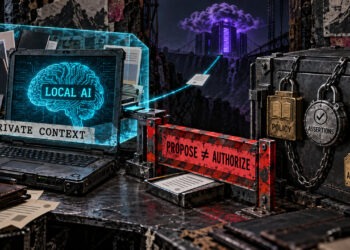
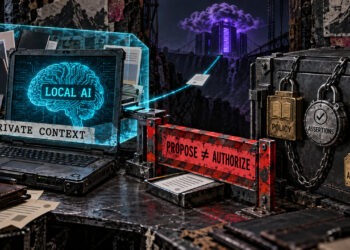
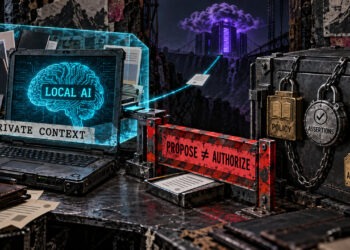
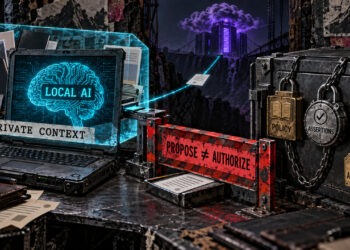
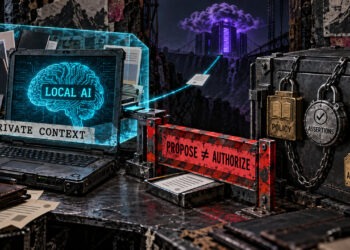
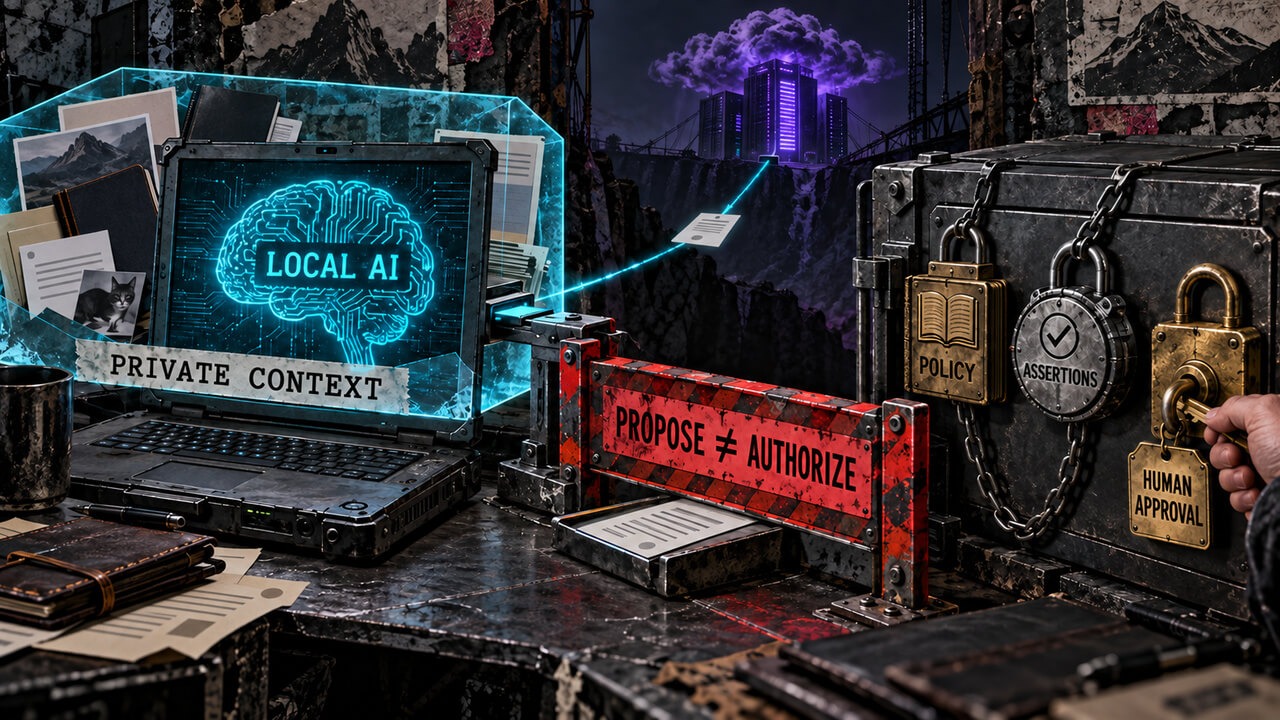
En su planteamiento más reciente, el modelo local puede asumir el papel de interfaz principal y decidir cuándo necesita recurrir a un servicio remoto. En lugar de enviar todos los archivos, mensajes y datos de la cartera, el sistema local seleccionaría únicamente la pregunta o el contexto necesario. Así, el modelo instalado en el dispositivo actuaría como asistente y filtro de información, con una mejora potencial para la privacidad.
La capacidad del modelo no equivale a autoridad sobre los fondos
Qwen3.8-Flash-Next, desarrollado por el equipo de Alibaba, es un modelo multimodal de pesos abiertos basado en una arquitectura de mezcla de expertos. Su modelo principal cuenta con 125.000 millones de parámetros y otros 51.000 millones en tablas de incrustaciones de n-gramas, aunque solo activa 6.000 millones de parámetros por token. La documentación oficial contempla su ejecución local mediante llama.cpp y versiones cuantizadas en formato GGUF.
Activar solo una parte del modelo reduce la carga de cálculo, pero el equipo debe disponer de memoria suficiente para la versión elegida y para el contexto utilizado. Los materiales oficiales no fijan un requisito de hardware único para todas las cuantizaciones y cargas de trabajo.
El informe técnico de Qwen compara el modelo en 14 pruebas de conocimiento general, matemáticas, ciencia, razonamiento, programación y comprensión multilingüe. El equipo de desarrollo aseguró que Flash-Next superó al modelo base Qwen3.7-Plus en ocho de esas pruebas, con menos parámetros activos y menor consumo de recursos de entrenamiento. Esos resultados miden capacidad y eficiencia, pero no resuelven cuestiones como la resistencia a la inyección de instrucciones, la aplicación de políticas de seguridad o la autorización de operaciones financieras.
Un asistente puede explicar una transacción, preparar datos de llamada o proponer una ruta de intercambio sin tener capacidad para ejecutarla. La firma, en cambio, puede iniciar una transferencia irreversible o conceder a un contrato permiso para mover activos. Por eso, una cartera no debería convertir la capacidad de razonamiento del modelo en autoridad ilimitada.
La protección debe estar fuera del modelo
La Fundación Ethereum ya ha incluido entre sus proyectos financiados a Steward, una cartera de cuenta inteligente para macOS cuyo cliente ligero y asistente de IA están diseñados para funcionar en el propio dispositivo. La información disponible confirma la financiación y el alcance del proyecto, pero no establece que exista un despliegue de producción, una auditoría independiente o autoridad autónoma para ejecutar transacciones.
La propuesta de seguridad atribuida a Buterin separa la asistencia de la autorización. Para las operaciones de riesgo plantea confirmación humana, límites deterministas sobre importes, datos de llamada y número de transacciones, además de una regla de aprobación conjunta entre la persona y el modelo. Las acciones de bajo riesgo, como consultar saldos o preparar transacciones sin firmarlas, pueden mantenerse dentro de permisos definidos por el software.
El borrador EIP-7906 añade otra capa posible: comprobaciones posteriores que examinan los cambios reales de estado provocados por una transacción. De este modo, una cartera podría rechazar una operación si altera saldos no autorizados, incorpora un permiso oculto sobre tokens o modifica una cuenta protegida. La eficacia dependería de que las reglas cubran todos los cambios relevantes y de que la validación no pueda omitirse.
El avance de la IA local hace más plausible una cartera capaz de entender instrucciones privadas y responder con rapidez. Pero la protección de los activos debe seguir descansando en límites que el modelo no pueda modificar, verificaciones deterministas y una aprobación humana significativa cuando la operación sea irreversible.